-
 AI 업무비서 실수해도 ‘처음부터 다시’ 없다…틀린 곳만 고친다
“지난해 가장 많이 팔린 상품을 찾아줘.” AI가 회사 자료를 찾는 과정에서 존재하지 않는 항목을 잘못 사용하면 검색이 실패할 수 있다. 지금까지는 작은 오류 하나에도 검색 명령 전체를 다시 만들어야 했지만, 우리 대학 연구진이 틀린 부분만 찾아 바로잡는 기술을 개발했다. AI의 데이터 검색을 더 빠르고 정확하게 만들어 기업의 ‘AI 업무비서’ 활용을 앞당길 것으로 기대된다.
우리 대학은 전산학부 김민수 교수 연구팀이 사람의 일상적인 질문을 데이터베이스에서 원하는 정보를 찾는 컴퓨터 명령어인 SQL(Structured Query Language)로 바꾸는 과정에서 발생하는 오류를 찾아 수정하는 기술 ‘세이프큐엘(SafeQL)’을 개발했다고 4일 밝혔다.
최근에는 “지난해 매출이 가장 많이 늘어난 상품은?”, “재고가 부족한 상품은?”처럼 일상적인 말로 질문하면 AI가 이를 SQL로 바꿔 회사의 매출·고객·재고 자료를 찾아주는 ‘Text-to-SQL’ 기술이 활용되고 있다. 복잡한 컴퓨터 명령어를 몰라도 말이나 글로 질문해 필요한 데이터를 찾을 수 있게 해주는 기술이다.
문제는 AI가 검색 명령을 만들면서 데이터베이스에 실제로 없는 테이블이나 항목의 이름을 잘못 사용하거나, 자료를 잘못 연결하는 등의 실수를 할 수 있다는 것이다. 이 경우 SQL이 실행되지 않아 AI가 필요한 데이터를 가져오지 못한다.
기존에는 이런 작은 오류 하나에도 오류 내용을 챗GPT와 같은 생성형 AI의 기반인 대형언어모델(LLM)에 다시 보내 검색 명령 전체를 새로 만들게 했다. 보고서에서 단어 하나가 틀렸다는 이유로 문서 전체를 다시 쓰는 것과 비슷하다. 이미 맞았던 부분까지 달라지거나 새로운 오류가 생길 수 있고, AI를 반복해서 사용하는 만큼 비용과 시간도 늘어난다.
SafeQL은 이 방식을 바꿨다. AI에게 검색 명령 전체를 다시 만들게 하는 대신, 데이터베이스가 알려주는 오류와 실제 저장된 정보를 이용해 어디가 잘못됐는지 찾아 해당 부분만 고친다. 존재하지 않는 테이블이나 항목을 사용했는지 확인하고, 빠진 자료의 연결이나 잘못 사용한 함수·검색값 등도 찾아 수정한다.
연구팀은 이를 위해 데이터베이스에서 실제로 실행할 수 있는 여러 수정안 가운데 원래 AI가 만든 명령과 가장 가까운 답부터 찾아가는 ‘안전 질의 공간(Safe Query Space)’ 방식을 설계했다. 쉽게 말해 가능한 수정안을 모두 확인하는 대신, 제대로 작동할 가능성이 높은 답부터 골라 확인하는 방식이다. 맞지 않는 후보를 미리 제외해 수정에 필요한 시간도 줄였다.
또한 SafeQL을 세계적으로 널리 사용되는 공개형 데이터베이스 관리 프로그램인 PostgreSQL 내부에 구현해 복잡한 명령에서도 오류가 발생한 위치를 정확하게 찾도록 했다. 틀린 부분만 고쳐서는 해결하기 어려운 경우에만 LLM을 다시 사용하도록 해 불필요한 AI 사용도 줄였다.
연구팀은 전 세계 연구자들이 AI의 데이터베이스 검색 능력을 비교하는 데 널리 사용하는 BIRD와 Spider 벤치마크를 통해 SafeQL의 성능을 검증했다.
특히 BIRD 벤치마크 평가에서 SafeQL은 AI가 처음 만든 SQL의 실행 오류를 최대 87.4% 해결했으며, 원하는 답을 정확하게 찾아내는 실행 정확도도 기존 최고 기술보다 최대 5.8%포인트 높였다. 검색 명령 전체를 AI에게 다시 만들게 하는 기존 방식과 비교하면 토큰 사용량은 최대 15.1배 줄이고, 오류 수정 시간은 최대 29.6배 단축했다.
SafeQL은 많은 데이터 요청을 처리하는 기업에서 특히 유용할 것으로 기대된다. AI가 매출·고객·재고 등 사내 데이터를 찾는 과정에서 오류가 발생해도 검색 명령 전체를 다시 만들지 않고 잘못된 부분만 빠르게 수정할 수 있기 때문이다. 이를 통해 AI 운영에 필요한 비용과 시간을 줄이고, 기업 데이터를 보다 정확하고 안정적으로 활용하는 ‘AI 에이전트’ 기반 업무 자동화를 앞당길 수 있을 것으로 기대된다.
김민수 교수는 “기업에서 AI가 실제 업무를 맡으려면 필요한 데이터를 정확하게 찾는 것이 중요하다”며 “SafeQL은 AI가 검색 과정에서 실수하더라도 처음부터 다시 하는 대신 틀린 부분만 바로잡아 오류와 비용, 시간을 함께 줄이는 기술로, 신뢰할 수 있는 AI 업무 자동화를 앞당길 것으로 기대한다”고 말했다.
이번 연구에는 KAIST 전산학부 이건호 연구원이 제1저자로 참여했으며 김민수 교수가 교신저자를 맡았다. 연구 결과는 9월 1일부터 5일까지 미국 보스턴에서 열리는 세계적인 데이터베이스 분야 국제학술대회 VLDB(International Conference on Very Large Data Bases)에서 발표될 예정이다.
※ 논문명: SafeQL: Search-based Refinement for Safe and Efficient LLM-based Text-to-SQL, DOI: 10.14778/3819518.3819545
※ 저자정보: 이건호(KAIST, 제1저자), 김민수(KAIST, 교신저자)
한편, 이번 연구는 과학기술정보통신부의 지원을 받은 한국연구재단(NRF)과 정보통신기획평가원(IITP)의 SW스타랩 사업의 지원을 받아 수행됐다.
2026.09.04
조회수 2554
-
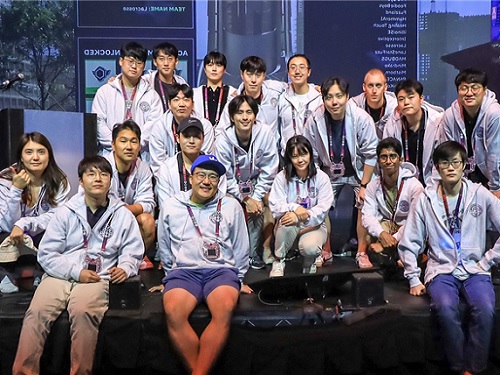 윤인수 교수팀, DARPA ‘AI 사이버 챌린지’ 결승 진출
지난 8월 8일부터 11일(현지 시각) 미국 라스베이거스에서 사이버 보안 분야 최고 학회 중 하나인 데프콘(DEF CON)에서 미국 고등연구계획국(이하 DARPA)의 주도하에 AI 사이버챌린지(AI Cyber Challenge, AIxCC)의 예선 대회가 진행됐다. 이는 AI를 활용한 차세대 해킹 시스템 경연 대회다.
우리 대학 전기및전자공학부 윤인수 교수 연구실이 속한 연합팀, 팀 애틀랜타(Team Atlanta)가 국내 대학이 포함된 팀으로서는 유일하게 톱(TOP) 7에 포함돼 내년 8월 개최 예정인 AI 사이버 챌린지 결승 진출팀으로 선정됐다고 21일 밝혔다.
팀 애틀랜타는 KAIST, 삼성 리서치, POSTECH, 조지아 공대의 연합팀으로, 현재 삼성 리서치 상무로 재직 중인 조지아 공대 김태수 교수의 연구실 출신 인원들이 주축이 되어 구성된 팀이다. 팀 이름은 조지아 공대가 있는 미국의 도시, 애틀랜타에서 유래했다.
팀 애틀랜타의 윤인수 교수는 세계적인 화이트 해커 출신 교수로, 세계 최고의 해킹 대회인 ‘DEF CON CTF(Capture the Flag)’에서 두 차례 우승하고 미국 해킹 대회인 ‘Pwn2Own 2020’에서 수상하는 등 뛰어난 성과를 거둔 바 있다. 학술적으로도 윤 교수는 보안 분야의 최우수 학회에 지속적으로 연구를 발표하고 있으며, 국제 학술대회 ‘USENIX Security 2018’, ‘USENIX OSDI 2018’에서 최우수 논문상을 수상하는 등 그 연구의 우수성을 인정받고 있다.
이번에 개최된 AI 사이버챌린지는 각 팀이 개발한 AI 기반의 사이버 추론 시스템(Cyber Reasoning System, 이하 CRS)을 겨루는 대회로, DARPA는 리눅스와 같은 실제 소프트웨어에 과거의 취약점이나 인위적인 취약점을 포함해 문제를 출제했으며, 각 팀의 CRS는 이 소프트웨어를 자동으로 분석해 취약점을 식별하고 패치하는 작업을 수행했다. 이후 DARPA는 취약점 발견 개수 및 다양성, 패치의 정확성 등을 종합적으로 고려해 각 CRS를 평가했다.
전 세계 총 91개 팀이 등록하고 39개 팀이 참여한 이번 예선에서, 팀 애틀랜타는 결승에 진출할 7개 팀 중 하나로 선정됐다. 특히, 팀 애틀랜타의 CRS는 예선 문제로 출제된 유명 소프트웨어인 SQLite3에서 출제자가 의도하지 않은 신규 취약점을 발견하는 성과를 거두기도 했다. 이는 AI가 보안 분야에 가져올 혁신의 가능성을 보여주며, AI 사이버챌린지의 목표와도 부합하는 중요한 성과로 평가된다.
팀 애틀랜타는 이번 결과로 200만 달러의 연구비(한화 약 27억 원)를 지원받게 됐으며, 2025년 8월 데프콘(DEF CON)에서 열리는 결승 대회에 진출해 최종 승부를 가리게 됐다.
최종 톱(TOP) 7에 선정돼 결승 대회에 진출하게 된 전기및전자공학부 윤인수 교수는 “오랫동안 준비한 대회에서 좋은 결과로 결승에 진출하게 되어 매우 기쁘다. 이번 결과는 KAIST를 비롯한 대한민국의 보안 연구 역량이 세계적으로도 우수한 수준에 도달했음을 보여준다고 생각한다”라며 소감을 전하면서, “앞으로 1년 동안 더 획기적이고 적극적인 방법들을 시도하며 AI와 보안의 접목에 혁신을 이끌어내고 본 대회를 우승 할 수 있도록 최선을 다하겠다”라고 향후 계획을 밝혔다.
2024.08.21
조회수 9724
-
 세계 최고 성능을 지닌 데이터베이스 관리 시스템(DBMS) 기술 개발
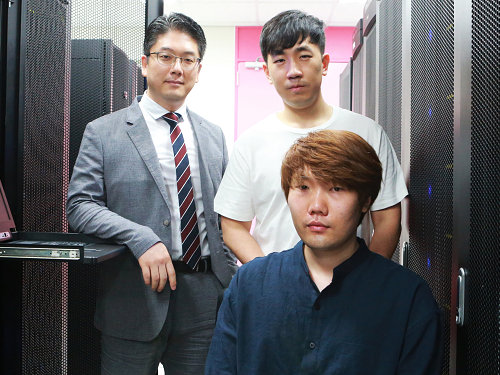
우리 연구진이 방대한 정보를 저장하고 목적에 맞게 검색, 관리할 수 있는 시스템을 통칭하는 데이터베이스관리시스템(DBMS, DataBase Management System)을 세계 최고 수준의 성능으로 끌어올렸다.
우리 대학 전산학부 김민수 교수 연구팀이 데이터베이스 질의 언어 SQL(Structured Query Language, 구조화 질의어) 처리 성능을 대폭 높인 세계 최고 수준의 DBMS 기술을 개발했다.
김 교수 연구팀은 데이터 처리를 위해 산업 표준으로 사용되는 SQL 질의를 기존 DBMS와는 전혀 다른 방법으로 처리함으로써 성능을 기존 옴니사이(OmniSci) DBMS 대비 최대 88배나 높인 신기술을 개발했다. 김 교수팀이 개발한 이 기술은 오라클·마이크로소프트 SQL서버·IBM DB2 등 타 DBMS에도 적용할 수 있어 고성능 SQL 질의 처리가 필요한 다양한 곳에 폭넓게 적용될 수 있을 것으로 기대된다.
대부분의 DBMS는 SQL 질의를 처리할 때 내부적으로 데이터 테이블들을 `왼쪽 깊은 이진 트리(left-deep binary tree)' 형태로 배치해 처리하는 방법을 사용한다. 지난 수십 년간 상용화돼 온 대부분의 DBMS는 데이터 테이블들의 배치 가능한 가지 수가 기하급수적으로 많기 때문에 이를 `왼쪽 깊은 이진 트리' 형태로 배치해 SQL 질의를 처리해 왔다.
임의의 두 테이블이 기본 키(primary key, PK)와 외래 키(foreign key, FK)라 불리는 관계로 결합(조인 연산)하는 경우에는 이러한 방법으로 SQL 질의를 효과적으로 처리할 수 있다. 여기서 기본 키는 각 데이터 행(row)을 유일하게 식별할 수 있는 열(column)이고, 외래 키는 그렇지 않은 열이다.
지난 수십 년간 산업에서 사용되는 DB의 구조가 점점 복잡해지면서 두 테이블은 PK-FK 관계가 아닌 FK-FK 관계, 즉 외래 키와 외래 키의 관계로 결합하는 복잡한 형태의 SQL 질의들이 많아지고 있다. 실제 DBMS의 성능을 측정하는 산업 표준 벤치마크인 TPC-DS에서 전체 벤치마크의 26%가 이런 복잡한 SQL 질의들로 구성돼 있고 기계학습(머신러닝), 생물 정보학 등 다양한 분야들서도 이러한 복잡한 SQL 질의 사용이 점차 증가하는 추세다.
이전에 나온 DBMS들은 두 테이블이 주로 PK-FK 관계로 결합한다는 가정하에 개발됐기 때문에 FK-FK 결합이 필요한 복잡한 SQL 질의를 매우 느리거나 심지어 처리하지 못하는 실패를 거듭해왔다.
김 교수팀은 문제 해결을 위해 테이블들을 하나의 커다란 `왼쪽 깊은 이진 트리' 형태가 아닌 여러 개의 작은 `왼쪽 깊은 이진 트리'를 `n항 조인 연산자'로 묶는 형태로 배치해 처리하는 기술을 개발했다. 이때 각각의 `작은 이진 트리' 안에는 FK-FK 결합 관계가 발생하지 않도록 테이블들을 배치하는 것이 핵심이다.
각각의 `작은 이진 트리'의 처리 결과물을 `n항 조인 연산자'로 결합해 최종 결과물을 구하는 것도 난제로 꼽히는데 연구팀은 `최악-최적(worst-case optimal) 조인 알고리즘'이라는 방법으로 이 문제를 해결했다.
`최악-최적 조인 알고리즘'은 그래프 데이터를 처리할 때 이론적으로 가장 우수하다고 알려진 알고리즘이다. 김 교수 연구팀은 세계에서 가장 먼저 이 알고리즘을 SQL 질의 처리에 적용해 난제를 해결하는 데 성공했다.
김민수 교수 연구팀은 새로 개발한 DBMS 기술을 GPU 기반의 DBMS 개발업체인 미국 옴니사이(OmniSci)社 제품에 적용한 결과, OmniSci DBMS보다 성능이 최대 88배나 향상된 결과를 얻었다. 또 TPC-DS 벤치마크에서도 세계 최고 수준의 성능을 가진 기존의 상용 DBMS보다 5~20배나 더 빠른 사실을 확인했다. TPC-DS는 DBMS의 성능을 측정하기 위한 산업 표준의 최신 벤치마크이다.
교신저자로 참여한 김민수 교수는 "연구팀이 개발한 새로운 기술은 대부분의 DBMS에 적용할 수 있기 때문에 산업적 측면에서 파급 효과가 매우 클 것으로 기대한다ˮ 라고 말했다.
이번 연구에는 김 교수의 제자이자 미국 옴니사이(OmniSci)社에 재직 중인 남윤민 박사가 제1 저자로, 김 교수가 교신저자로 참여했으며 지난 18일 미국 오리건주 포틀랜드에서 열린 데이터베이스 분야 최고의 국제학술대회로 꼽히는 `시그모드(SIGMOD)'에서 발표됐다. (논문명 : SPRINTER: A Fast n-ary Join Query Processing Method for Complex OLAP Queries).
한편, 이 연구는 한국연구재단 선도연구센터 사업 및 중견연구자 지원사업, 과기정통부 IITP SW스타랩 사업의 지원을 받아 수행됐다.
2020.06.23
조회수 28937